BERT : comment fonctionne le modèle de Google et à quoi il sert encore
Vous croisez BERT dans un article SEO ou un débat sur ChatGPT, sans savoir ce qu’il fait ? C’est un modèle de langage publié par Google en 2018, qui comprend chaque mot grâce à ceux placés avant et après lui. Google s’en sert dans sa recherche depuis 2019, et ses descendants trient du texte en entreprise.
On confond souvent BERT et ChatGPT. Les deux sortent de la même famille technique, les transformeurs, mais l’un lit et classe du texte quand l’autre en écrit.
Qu’est-ce que BERT, exactement ?
BERT est un modèle de traitement du langage publié par Google en octobre 2018, puis rendu open source le mois suivant. Son nom est un sigle anglais :
- Bidirectional (bidirectionnel) : il tient compte des mots placés avant et après.
- Encoder (encodeur) : il traduit le texte en nombres, sans rien rédiger.
- Representations (représentations) : il chiffre le sens de chaque mot.
- Transformers (transformeurs) : il appartient à la même famille que GPT.
Ces représentations servent ensuite à classer un texte, répondre à une question, repérer un nom propre… BERT sert à comprendre ; si vous attendez de lui qu’il rédige, vous vous trompez d’outil.
À sa sortie, BERT a fait date en battant les records sur 11 tâches, selon Google Research. Sur le test de questions-réponses SQuAD, il portait d’un coup le record de 91,6 à 93,2 en score F1 !
Comment BERT comprend le sens d’un mot
Il lit la phrase dans les deux sens
BERT découpe d’abord le texte en tokens, des morceaux de mots, puis son mécanisme d’attention pèse chaque token au regard de tous les autres. Surtout, BERT regarde des deux côtés du mot à la fois, quand GPT ne voit que ce qui précède.
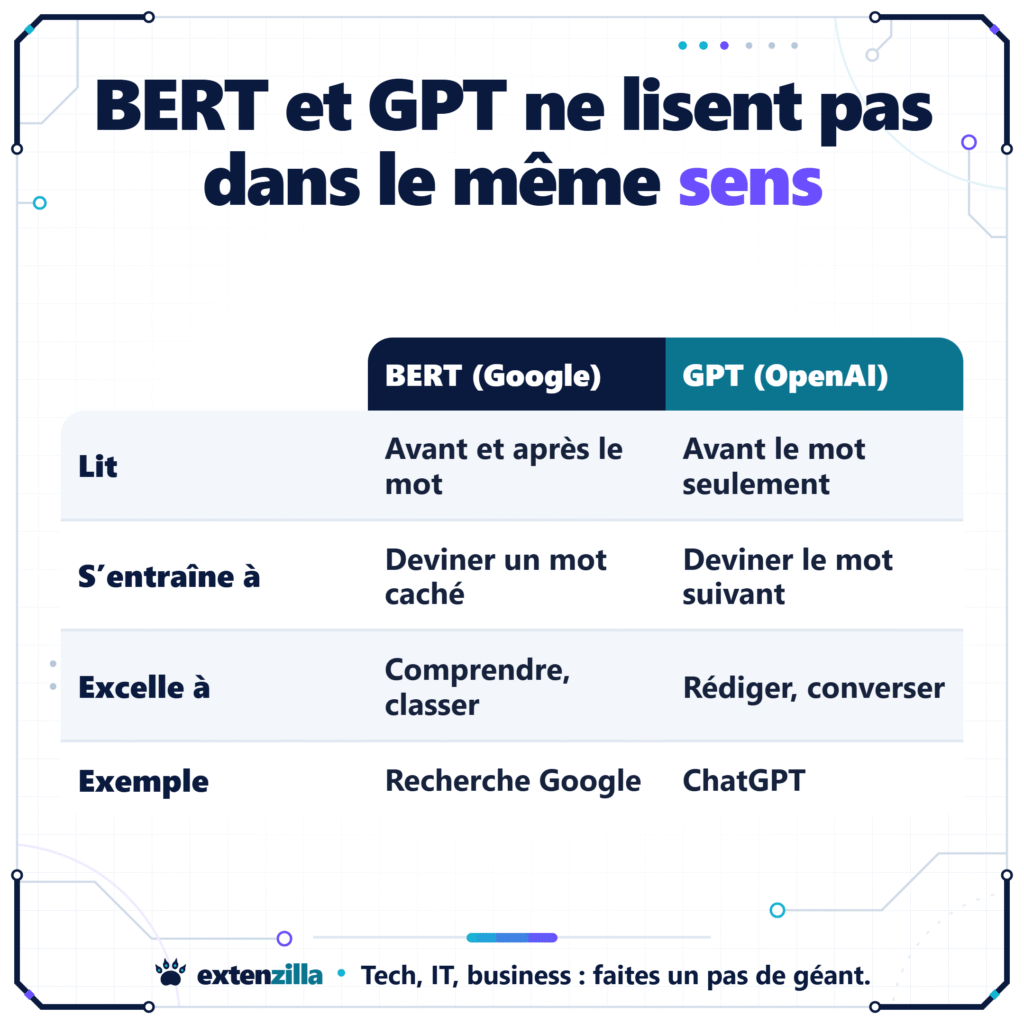
Il apprend en devinant des mots cachés
Selon l’article fondateur de Jacob Devlin et ses coauteurs, BERT s’est entraîné sur 3,3 milliards de mots de livres et de Wikipédia. Dans chaque séquence, 15 % des tokens étaient masqués, et il devait les retrouver.
Il devait aussi dire si une phrase B suit bien une phrase A. Le coup de génie de BERT tient pourtant dans ce texte à trous, un exercice d’école répété sur des milliards de mots. Google a publié BERT en deux tailles, base (110 millions de paramètres) et large (340 millions).
Il se spécialise avec peu d’exemples
Le fine-tuning consiste à ajouter à BERT une couche de sortie, puis à l’entraîner sur des exemples annotés, comme des avis clients classés positifs ou négatifs.
Bonne nouvelle, cette étape coûte peu ! En 2018, Google indiquait qu’un système de questions-réponses s’entraînait en une trentaine de minutes sur un Cloud TPU, ou en quelques heures sur un GPU. Le gros du travail est fait une fois pour toutes, par Google.
Ce que BERT a changé dans la recherche Google
Depuis octobre 2019, Google utilise BERT pour comprendre les requêtes, surtout les longues et celles où un petit mot change le sens. À son lancement, il intervenait dans une recherche sur 10 aux États-Unis, en anglais, ainsi que dans les extraits optimisés de deux douzaines de pays.
Dans l’exemple publié par Google, sur « 2019 brazil traveler to usa need a visa », le moteur montrait des pages pour les Américains partant au Brésil ; avec BERT, il saisit le « to » et répond aux Brésiliens qui partent aux États-Unis !
En novembre 2026, BERT figure toujours parmi les systèmes de classement de Google, à côté de RankBrain. Il aide le moteur à saisir le sens d’une requête, sans noter la qualité d’un site. Pour vos pages, voici ce qui change :
- Les requêtes longues sont mieux comprises ; une page qui traite la question précise a sa chance.
- Les petits mots comptent (« pour », « vers », « sans »…), inutile d’écrire en style télégraphique.
- Google ne documente aucune recette « spéciale BERT » ; une réponse claire à la question exacte fait l’affaire.
Quel BERT choisir pour un texte en français ?
Pour du français, un modèle entraîné sur du français fait mieux que le BERT d’origine, pensé pour l’anglais, ou que sa déclinaison multilingue.
| Modèle | Année | Conçu par | Langue | À retenir |
|---|---|---|---|---|
| BERT | 2018 | Anglais, puis multilingue | 512 tokens au plus | |
| CamemBERT | 2019 | Inria et Facebook AI Research | Français | 4 Go de web suffisent |
| FlauBERT | 2019 | Université Grenoble Alpes et CNRS | Français | Entraîné sur Jean Zay (CNRS) |
| DistilBERT | 2019 | Hugging Face | Anglais | 40 % plus léger, 60 % plus rapide |
| CamemBERT 2.0 | 2024 | Inria | Français | Données récentes, contexte plus long |
| ModernBERT | 2024 | Answer.AI, LightOn et partenaires | Anglais, code | 8 192 tokens |
Source : articles des équipes citées, arXiv (2018 à 2024)
Bâti sur RoBERTa, une variante de BERT, CamemBERT a montré qu’un modèle entraîné sur 4 Go de texte web obtient d’aussi bons résultats qu’avec plus de 130 Go, un corpus plus de trente fois plus lourd ! La variété du texte compte davantage que son volume.
Restait la dérive temporelle, qui rend un modèle nourri de textes anciens peu à l’aise avec le vocabulaire récent. Inria y a répondu en novembre 2024 avec CamemBERT 2.0, entraîné sur des données récentes, au contexte plus long.
Conçu surtout pour l’anglais et le code, ModernBERT est allé bien plus loin un mois plus tard, avec 8 192 tokens lus d’un coup, seize fois les 512 du BERT d’origine.
Vous traitez des documents en français ? Mieux vaut alors partir d’un modèle entraîné sur du français, CamemBERT 2.0 en tête, que du BERT multilingue d’origine.
BERT sert-il encore face à ChatGPT ?
Oui, BERT reste utile pour lire du texte en volume et en tirer une étiquette, un score ou un résultat de recherche. Pour rédiger, en revanche, il ne sert à rien. Google s’en sert toujours, et CamemBERT dépassait fin 2024 les 4 millions de téléchargements mensuels, selon Inria.
La famille BERT tire son épingle du jeu dès qu’il faut trier, analyser ou retrouver du texte, y compris pour les systèmes RAG, qui fournissent à un LLM les bons passages.
| Besoin | Famille BERT | LLM génératif |
|---|---|---|
| Trier des e-mails ou des tickets | Adapté, rapide, en interne | Possible, plus lourd |
| Repérer le ton d’avis clients | Adapté | Possible, plus lourd |
| Retrouver un document par son sens (RAG) | Adapté, c’est son terrain | Rédige la réponse finale |
| Masquer noms et adresses | Adapté | Possible, sortie à vérifier |
| Rédiger une réponse ou un résumé | Inadapté | Adapté |
| Tester une idée sans exemples annotés | Inadapté | Adapté |
Pourquoi cette légèreté ? Un BERT compte 110 à 340 millions de paramètres, contre 175 milliards pour GPT-3 (OpenAI, 2020). Dès lors, un serveur modeste suffit, les données peuvent rester en interne et la sortie, une catégorie, se vérifie facilement.
En contrepartie, BERT ne rédige pas et demande en outre des exemples annotés, là où un LLM répond sur simple consigne.
Le bon montage combine souvent les deux familles. Prenons le service client d’une PME qui reçoit des centaines d’e-mails par jour. Un CamemBERT entraîné sur les messages classés l’an passé répartit les nouveaux e-mails entre SAV, facturation et commercial, sur un serveur interne.
Un LLM propose ensuite un brouillon de réponse, que l’agent relit avant l’envoi.
Quiz · 5 questions
BERT, vous suivez ?
BERT a appris aux machines à lire un mot avec tout son entourage, une idée qui tourne encore en coulisses chez Google. Si vous gérez un site, rien à régler pour BERT ; tout tient à la clarté de vos pages.
Pour classer ou retrouver du texte, un modèle de la famille BERT, en français de préférence, fera le travail à moindre coût ; pour en produire, il vous faut en revanche un LLM génératif.
FAQ - Questions fréquentes
BERT est-il un LLM ?
C’est un modèle de langage, mais 500 à 1 600 fois plus petit que GPT-3 et incapable de rédiger. On le classe parmi les encodeurs.
BERT est-il gratuit ?
Oui, Google l’a publié en open source en novembre 2018. Ses descendants (CamemBERT, ModernBERT…) le sont aussi ; chaque licence mérite toutefois une lecture avant un usage commercial.
BERT a-t-il remplacé RankBrain ?
Non, les deux restent actifs chez Google. RankBrain relie les mots à des concepts ; BERT saisit comment leur combinaison change le sens.
Qui a créé BERT ?
BERT est signé Jacob Devlin, Ming-Wei Chang, Kenton Lee et Kristina Toutanova, chercheurs de Google AI Language. Leur article date d’octobre 2018.

L'auteur
Romain Frutos
Consultant SEO · Fondateur d'Extenzilla
Il accompagne depuis 6 ans entreprises et agences sur leur visibilité : SEO technique, stratégie sémantique, netlinking, et désormais visibilité dans les moteurs IA.