
Vous regardez vos concurrents annoncer chaque semaine une nouvelle fonctionnalité « propulsée par l’IA », et vous vous demandez comment intégrer intelligemment ces briques dans votre propre produit sans partir dans tous les sens ? Vous n’êtes pas seul. Depuis 2024, les équipes produit doivent composer avec une équation complexe : intégrer de l’IA pour rester dans la course, sans dégrader l’expérience utilisateur, sans faire exploser les coûts, et sans céder aux effets de mode. La bonne nouvelle, c’est qu’une méthode pragmatique existe. Nous allons voir ensemble les cas d’usage à prioriser, les étapes concrètes d’intégration, et surtout les pièges silencieux qui font échouer la plupart des projets IA.
Pourquoi l’IA transforme vos produits digitaux dès aujourd’hui
L’IA n’est plus une option différenciante, c’est devenu une attente utilisateur. Selon une étude Gartner, plus de 80 % des entreprises auront utilisé des APIs d’IA générative ou déployé des applications propulsées par l’IA d’ici 2026, contre moins de 5 % en 2023. Autrement dit : votre produit sera comparé à des concurrents dotés d’assistants intelligents, de recommandations personnalisées et d’automatisations avancées.
Mais l’enjeu dépasse largement l’effet vitrine. L’IA vous permet aujourd’hui de résoudre des problèmes utilisateurs qui étaient hors de portée il y a deux ans : synthétiser un long document en trois secondes, comprendre une demande formulée en langage naturel, prédire un comportement de churn, ou générer un contenu personnalisé à la volée. La vraie question n’est donc plus « faut-il intégrer de l’IA ? » mais « quelle brique intégrer, pour quel utilisateur, et à quel coût ? ».
Quels cas d’usage prioriser pour une première intégration IA
Toutes les fonctionnalités IA ne se valent pas. Certaines apportent une valeur immédiate, d’autres relèvent du gadget coûteux. Voici les trois familles de cas d’usage qui présentent le meilleur ratio impact/complexité pour un premier chantier.
La personnalisation de l’expérience
Adapter dynamiquement le parcours utilisateur en fonction de son historique, de son contexte ou de ses préférences. Cas typiques : recommandations produits, tableaux de bord personnalisés, priorisation intelligente des contenus dans un feed. L’impact business se mesure rapidement (taux de conversion, rétention, temps passé sur l’application) et l’intégration technique reste relativement contenue.
L’automatisation des tâches répétitives
Extraction de données depuis des documents, tri automatique de tickets support, catégorisation d’emails entrants, génération de résumés de réunions. C’est souvent le premier chantier IA que nous recommandons, car il libère du temps utilisateur sans transformer radicalement l’interface. La courbe d’adoption est douce et le retour sur investissement s’objective facilement.
L’assistance conversationnelle et la recherche augmentée
Chatbots métier, assistants embarqués dans l’interface, recherche sémantique dans une base documentaire. Attention : ces cas d’usage sont les plus visibles, mais aussi les plus exigeants en termes de qualité de réponse et de fiabilité des sources. Une hallucination sur un chatbot public peut vous coûter très cher en réputation. Prévoyez du temps de recette.
La méthode en 5 étapes pour intégrer l’IA sans se disperser
Vous avez identifié un cas d’usage prometteur ? Voici la séquence que suivent les équipes produit qui réussissent leur intégration IA sans y laisser six mois de roadmap.
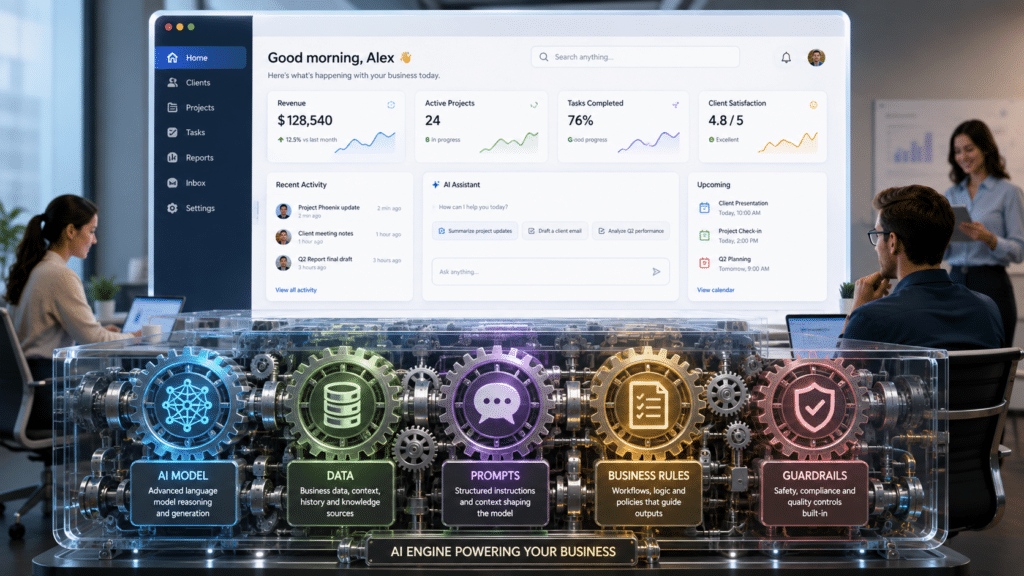
Une intégration IA solide repose sur cinq briques complémentaires : le modèle de langage lui-même, les données métier qui l’alimentent, les prompts qui structurent ses réponses, les règles métier qui encadrent son comportement, et les garde-fous qui sécurisent son utilisation. Aucune de ces briques ne peut être négligée sans compromettre l’ensemble.
Étape 1 : cadrez le problème utilisateur avant la solution technique
Formulez le problème en une phrase, sans mentionner le mot « IA ». Si vous n’y arrivez pas, le projet est mal cadré et vous foncez droit dans le mur. La technologie doit toujours rester au service d’un besoin utilisateur clairement identifié.
Étape 2 : choisissez la bonne brique technique
API prête à l’emploi (OpenAI, Anthropic, Mistral), modèle open source auto-hébergé, ou fine-tuning sur mesure ? Le choix dépend de la sensibilité des données que vous traitez, du volume de requêtes attendu, et de vos contraintes de latence. Une API généraliste couvre 80 % des besoins en phase de démarrage.
Étape 3 : prototypez vite et mesurez tôt
Un MVP fonctionnel en deux semaines vaut mieux qu’une architecture parfaite en six mois. Testez sur un panel restreint d’utilisateurs, mesurez la satisfaction perçue, les coûts d’inférence réels et la qualité des réponses. Un prototype mal reçu par 20 utilisateurs ne s’améliorera pas magiquement à 20 000.
Étape 4 : industrialisez et sécurisez
Passage en production : monitoring des prompts, gestion des cas d’erreur, garde-fous anti-hallucination, conformité RGPD, traçabilité des décisions IA en cas de contestation utilisateur. Ne sous-estimez jamais cette phase, c’est souvent là que les équipes se cassent les dents.
Étape 5 : monitorez, itérez, décommissionnez si besoin
Une fonctionnalité IA doit se piloter comme un produit à part entière. Suivez son usage réel, ses coûts unitaires, sa dérive de qualité au fil des mises à jour du modèle sous-jacent. Et acceptez de la retirer si elle n’apporte pas la valeur attendue. Une feature IA maintenue par habitude coûte plus qu’elle ne rapporte.
Les pièges classiques qui plombent silencieusement les projets IA
Voici ce que personne ne vous dit dans les articles de blog enthousiastes.
Le premier piège, c’est l’explosion des coûts d’inférence. Une fonctionnalité anodine à 500 utilisateurs peut coûter 5 000 € par mois à 50 000 utilisateurs. Vous devez modéliser le coût par utilisateur actif dès la phase de prototype, sinon vous découvrirez la facture au pire moment.
Le deuxième piège s’appelle la dette de prompt. Vos prompts évoluent au fil des versions du modèle sous-jacent, sans versioning ni tests de non-régression. Un modèle mis à jour côté fournisseur peut casser silencieusement votre fonctionnalité du jour au lendemain, sans qu’aucune alerte ne se déclenche.
Le troisième piège, c’est l’effet vitrine. Ajouter une fonctionnalité « propulsée par l’IA » pour cocher une case marketing, sans qu’elle réponde à un vrai besoin utilisateur. Résultat : un usage marginal, une maintenance coûteuse, et une perte de confiance dans votre roadmap produit.
Le quatrième piège concerne la confiance utilisateur. Si votre IA se trompe visiblement une fois sur dix, les 90 % de bonnes réponses ne comptent plus. La perception de fiabilité prime toujours sur la performance moyenne. Prévoyez systématiquement un mécanisme de feedback, un mode « je ne sais pas » assumé, et une possibilité de correction humaine visible.
Vous entourer des bons profils dès la phase de cadrage
Une intégration IA réussie repose rarement sur un seul développeur qui « bidouille l’API OpenAI » le soir. Vous avez besoin d’un binôme produit/data qui comprend à la fois les enjeux métier, les contraintes techniques et les subtilités des modèles de langage. Selon la maturité de vos équipes internes, il peut être pertinent de vous appuyer sur des partenaires disposant d’une véritable expertise en data science et IA pour cadrer votre roadmap, sécuriser vos choix d’architecture et éviter les mois d’errance sur des impasses techniques. Un accompagnement de quelques semaines en phase amont coûte souvent moins cher qu’un projet reparti de zéro six mois plus tard.
FAQ – Vos questions sur l’intégration de l’IA dans un produit digital
Combien coûte l’intégration d’une fonctionnalité IA dans un produit digital ?
Pour un cas d’usage simple via API tierce, comptez entre 3 000 et 15 000 € pour un MVP fonctionnel. Les coûts récurrents d’inférence dépendent ensuite du volume : de quelques centaines à plusieurs milliers d’euros mensuels selon la charge et le modèle retenu. Un fine-tuning ou un modèle auto-hébergé demande un budget nettement supérieur.
Faut-il utiliser un modèle propriétaire ou un modèle open source ?
Un modèle propriétaire (GPT, Claude, Gemini) offre une qualité élevée sans effort d’infrastructure. Un modèle open source auto-hébergé (Llama, Mistral, Qwen) vous donne le contrôle des données et des coûts prévisibles à volume élevé. Le choix dépend de vos contraintes de souveraineté, de scalabilité et de latence.
Comment gérer les hallucinations de l’IA dans un produit en production ?
Combinez plusieurs approches : ancrage sur vos sources internes (technique RAG), garde-fous côté prompt, validation par un second modèle sur les réponses sensibles, et surtout un mécanisme de feedback utilisateur pour détecter les dérives dans le temps. Aucune approche seule n’est suffisante.
Combien de temps faut-il pour mettre en production une première fonctionnalité IA ?
Sur un cas d’usage bien cadré avec une API tierce, comptez 4 à 8 semaines entre le prototype fonctionnel et la mise en production sécurisée. Les projets qui dépassent ce délai souffrent presque toujours d’un problème de cadrage initial, rarement d’un problème technique.