Logiciels & SaaSApplis & tutoriels
Wayback Machine web : retrouver l’ancienne version d’un site
Pour retrouver une page disparue, revoir l’ancien site d’un concurrent ou sonder le passé d’un domaine expiré, le premier réflexe s’appelle la Wayback Machine web d’Internet Archive. Sur web.archive.org, vous saisissez l’adresse d’une page, vous choisissez une date, et elle s’affiche gratuitement telle qu’elle était, à condition que les robots de l’archive soient passés par là.
Le geste est simple, mais l’outil a des trous qu’il faut savoir lire, et une capture ne prouve pas tout.
Que conserve vraiment la Wayback Machine web ?
La Wayback Machine est un service gratuit d’Internet Archive, une organisation à but non lucratif, qui conserve des captures horodatées de pages web publiques. Elle fonctionne toujours, en ligne et sans abonnement. Son ambition est de garder la mémoire du web mondial, sans promettre pour autant que votre site y figure, puisqu’il n’existe aucune garantie d’archivage pour un site donné.
Ces captures arrivent par deux chemins. La plupart viennent de robots qui parcourent le web de lien en lien, et les autres sont déclenchées à la main par les internautes avec Save Page Now.
Ce qu’on retrouve ensuite, c’est la page telle qu’elle s’affichait à un moment précis, avec ses images et ses feuilles de style quand les robots ont pu les prendre. De fait, cette web archive n’est fidèle qu’à ce qu’elle a réussi à collecter. Un site vitrine en HTML simple s’y retrouve presque à l’identique ; une application qui charge son contenu en JavaScript laisse souvent une coquille vide, avec des images cassées.
Certaines pages échappent d’ailleurs d’emblée aux robots, comme celles protégées par un mot de passe ou celles qu’aucun lien ne signale, puisque rien ne trahit leur existence. L’archive ne se fouille pas non plus dans le texte des pages, faute de recherche plein texte. Un mot-clé peut au mieux vous mener à la page d’accueil d’un site, si bien que pour une page précise, c’est son adresse qu’il faut chercher.
On peut donc se la représenter comme une mémoire immense mais trouée. Vous connaissez l’URL de la page perdue ? L’archive vous répond en quelques secondes, alors que sans adresse, la recherche d’un article lu il y a cinq ans risque fort de faire chou blanc.
Comment consulter un site sur la Wayback Machine ?
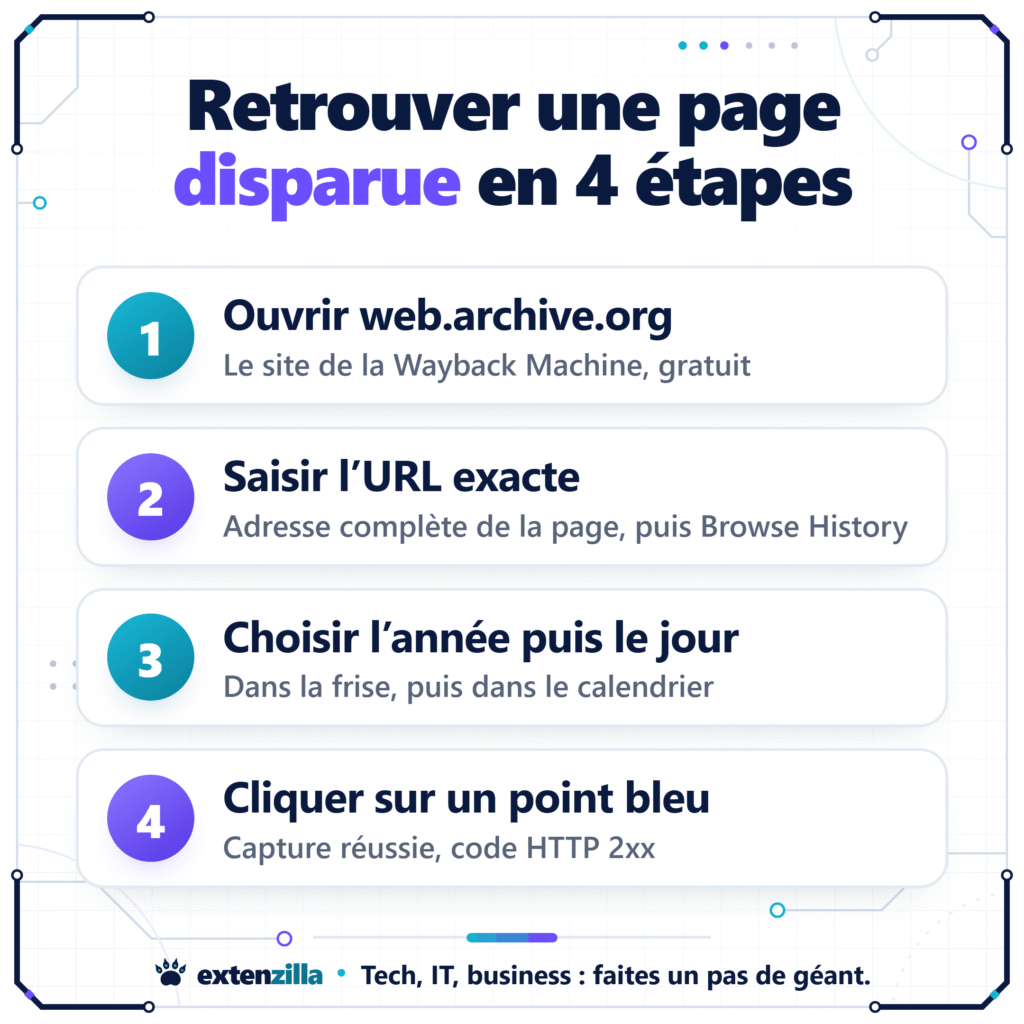
Consulter une page archivée tient en quatre gestes. Vous ouvrez web.archive.org, vous saisissez l’URL de la page et vous cliquez sur « Browse History », puis vous choisissez une année dans la frise et un jour dans le calendrier.
Saisir l’adresse exacte
Tout se joue dès le premier champ, parce que l’archive range ses captures par adresse. Une sous-page se cherche donc avec son URL complète, puisque le domaine seul ne vous mènera qu’à la page d’accueil. Pour l’ancienne page de tarifs d’un concurrent, c’est exemple.fr/tarifs qu’il faut saisir.
Et si vous ignorez l’adresse exacte ? L’astérisque vient alors à la rescousse. Ajouté après le domaine (exemple.fr/*), il liste toutes les adresses archivées du site, ce qui vous laisse repérer la bonne. L’URL exacte fait la moitié du travail, et chercher un domaine quand on veut une page précise revient à se perdre dans le calendrier.
Lire le calendrier des captures
Dans le calendrier, chaque jour qui compte au moins une capture porte un point coloré. Cette couleur reprend le code HTTP que le serveur a renvoyé au robot ce jour-là.
| Couleur | Code HTTP | Ce que vous verrez |
|---|---|---|
| Bleu | 2xx | La page archivée |
| Vert | 3xx | Une redirection vers une autre adresse |
| Orange | 4xx | Une erreur (page introuvable, accès refusé) |
| Rouge | 5xx | Une panne du serveur au moment de la capture |
Source : Internet Archive, centre d’aide
Vous tombez sur un point orange ou rouge ? La capture existe, mais elle n’a enregistré qu’une erreur, si bien que seuls les points bleus vous montrent vraiment la page. Un même jour peut porter plusieurs captures, à des heures différentes. Dans la page archivée, chaque lien mène ensuite à la capture la plus proche dans le temps, ce qui explique qu’un clic vous fasse parfois changer de mois, voire d’année…
Aller directement à une date
Le calendrier a un raccourci, l’adresse elle-même. Chaque capture porte une URL qui contient sa date au format AAAAMMJJhhmmss (année, mois, jour, heure, minutes, secondes), et vous pouvez la taper directement. Mieux encore, la date n’a pas besoin d’être complète ! Avec une année seule, l’archive vous renvoie vers une capture proche de cette année-là, dont la date exacte s’affiche dans l’adresse.
Voici trois adresses types, à adapter à la page que vous cherchez :
# Toutes les captures enregistrées pour cette adresse
web.archive.org/web/*/exemple.fr

# Une capture proche de l'année 2015 (date exacte visible dans l'adresse)
web.archive.org/web/2015/https://www.exemple.fr/

# La capture la plus proche du 1er janvier 2020 à minuit
web.archive.org/web/20200101000000/https://www.exemple.fr/tarifs
Une fois ce format compris, la suite coule de source, d’autant que ces adresses se partagent et se citent telles quelles.
Quels usages pour un site professionnel ?
Récupérer un contenu supprimé
Vous avez perdu un article lors d’une migration ou d’une fausse manœuvre ? S’il était en ligne depuis un moment, les robots l’ont peut-être enregistré, et son texte se récupère depuis la capture la plus récente. Les images, en revanche, manquent souvent à l’appel.
L’archive reste donc un filet de secours, pas une sauvegarde. Une entreprise qui compte sur elle pour protéger ses contenus joue avec le feu, puisque rien ne garantit qu’une page a été capturée, ni à quelle date. La vraie copie se règle chez votre hébergeur, un point à examiner au moment de choisir un hébergeur web. Et si c’est le site entier qui a disparu, notre article sur la disparition d’un site internet détaille comment gérer la crise.
Vérifier un domaine avant de l’acheter
Un nom de domaine expiré arrive avec son passé. Avant de l’acheter, vous pouvez parcourir ses captures depuis les premières années, à la recherche de pages de liens en masse, de contenus sans rapport avec votre activité, de textes écrits pour les robots plutôt que pour les lecteurs…
Prenons une agence qui s’apprête à racheter, pour un client du tourisme, un domaine expiré au nom flatteur. Les captures de 2019 révèlent un annuaire de liens vers des sites de paris en ligne, de quoi lui mettre la puce à l’oreille. Elle renonce, et elle a bien fait ! Un domaine au passé douteux traîne son historique, et c’est son client qui en aurait hérité.
La même méthode sert à la veille, puisqu’en comparant deux captures espacées de quelques mois, vous datez la refonte d’un concurrent ou la disparition d’une de ses offres.
Archiver une page avant qu’elle change
Reste le cas inverse, celui de la page encore en ligne que vous voulez figer avant qu’elle bouge. C’est le rôle de Save Page Now, sur la page d’accueil de la Wayback Machine. Vous collez l’adresse, et l’outil enregistre la page à cet instant, à condition qu’elle soit publique et consultable sans connexion.
Ses limites, cela dit, méritent d’être connues. L’outil enregistre une seule page, une seule fois, sans l’ajouter aux collectes futures, et ne sauvegarde ni un répertoire ni un site entier. Vous obtenez néanmoins une URL horodatée à citer, ce qui comptera le jour où la page deviendra une preuve.
Pourquoi votre page manque-t-elle à l’archive ?
Vous avez saisi l’adresse et l’archive ne trouve rien ? Ce silence a presque toujours une explication technique, et une page peut manquer pour six raisons :
- Les robots ignoraient son existence au moment de leur passage
- Aucun lien ne pointait vers elle, ce qui en faisait une page orpheline
- Elle était protégée par un mot de passe
- Le site bloquait les robots par son fichier robots.txt ou une balise meta robots
- Le site était inaccessible aux robots pour une autre raison
- Son propriétaire a demandé l’exclusion de ses pages
D’autres pages sont bien là, mais s’affichent mal. Le JavaScript se restitue difficilement, si bien que des images cassées apparaissent et que certains liens renvoient vers le web actuel. Il faut aussi compter 3 à 10 heures entre le passage d’un robot et l’apparition de sa capture.
Une cause plus récente touche la presse. Au tournant de 2026, plusieurs grands titres ont limité l’accès des robots d’Internet Archive, par crainte que des entreprises d’IA récupèrent leurs articles en passant par l’archive. Le New York Times bloque ces robots et le Guardian a retiré ses pages d’articles de l’interface de la Wayback Machine ; en France, Le Monde et Le HuffPost leur ferment eux aussi la porte. Leurs captures récentes se raréfient d’autant.
Une absence ne prouve donc rien. Avant de conclure qu’une page n’a jamais existé, vous pouvez essayer les variantes de son chemin (avec ou sans barre oblique finale, avec ou sans paramètres) et vous assurer que la date visée n’est pas trop récente.
Et si c’est votre propre site que vous voulez retirer ? Internet Archive examine les demandes d’exclusion envoyées à info@archive.org, sans garantie de résultat.
Le web français a aussi ses archives à la BnF
Quand la Wayback Machine n’a rien sur un vieux site français, tout n’est pas perdu ! Les archives de l’internet de la Bibliothèque nationale de France forment un second guichet, auquel peu de gens pensent.
La BnF collecte en effet des sites web au titre du dépôt légal, à intervalles réguliers. Ses robots descendent plus en profondeur dans les sites, si bien qu’elle juge sa couverture du web français meilleure que celle d’Internet Archive depuis le début des années 2000. Les deux collections se complètent, et la recherche s’y fait aussi par adresse.
La contrepartie, c’est qu’il faut se déplacer. Les archives se consultent dans les salles Recherche des sites de la BnF, dont le pass recherche est le sésame, sur les postes en accès libre ou sur votre ordinateur avec une application dédiée ; des bibliothèques de dépôt légal en région les ouvrent aussi, chacune avec ses conditions.
La porte est ouverte à toute personne qui justifie d’une recherche académique, professionnelle ou personnelle. Les collections restent hors ligne par respect de la propriété intellectuelle, alors qu’Internet Archive publie d’abord et retire sur demande.
| Critère | Wayback Machine | Archives de l’internet BnF |
|---|---|---|
| Accès | En ligne, partout | Sur place, à la BnF et en région |
| Public | Tout le monde | Toute personne justifiant d’une recherche |
| Coût | Gratuit | Pass recherche à la BnF, conditions locales en région |
| Recherche | Par adresse | Par adresse |
| Point fort | Rapidité, échelle mondiale | Couverture du web français |
Source : Internet Archive, Bibliothèque nationale de France
Pour un vieux site français disparu, la BnF vaut donc le déplacement, surtout si la Wayback Machine n’en garde que la page d’accueil. Pour une vérification rapide, l’archive d’Internet Archive reste le premier réflexe, parce qu’elle répond en ligne.
Une capture d’archive vaut-elle preuve ?
Une capture peut dater une publication devant certains offices, mais elle se manie avec prudence devant un juge. Quand un examinateur de l’Office européen des brevets tombe sur une page web sans date, ses directives d’examen citent la Wayback Machine comme le plus connu des services d’archives qui aident à établir sa date de publication.
Ces directives répondent même d’avance à l’objection la plus évidente, puisque le caractère incomplet de l’archive n’ôte rien, selon elles, à la crédibilité des données qu’elle contient. Une capture peut dès lors étayer l’antériorité d’une divulgation en ligne.
En France, devant un tribunal, la capture reste un indice parmi d’autres, que la partie adverse peut contester. Vous comptez vous en servir dans un litige ? Pour figer un contenu en ligne de façon solide, l’usage reste le constat d’un commissaire de justice, et l’avis d’un avocat quand l’enjeu le justifie.
Cette prudence a aussi une raison technique. Une capture n’est pas un bloc figé ; ses images, ses feuilles de style et ses scripts peuvent venir de captures prises à d’autres dates, voire du web actuel. Le texte peut ainsi dater de 2019 et le logo affiché à côté de 2021, sans que la page archivée le montre d’elle-même ! Pour voir la date de chaque élément, il faut ouvrir « About this capture », dans la barre de la Wayback Machine.
Pour qu’une capture tienne la route le jour où vous en aurez besoin, voici la méthode :
- Copier l’URL horodatée complète, qui contient la date exacte de la capture
- Vérifier la date des éléments clés, chaque image ayant sa propre adresse datée
- Lancer une sauvegarde Save Page Now le jour même si la page est encore en ligne
- Conserver une copie locale de la page et de la capture
- Passer par un commissaire de justice si un litige est probable
Si vous suivez de près les pages d’un concurrent, l’archive s’interroge aussi de façon automatisée, grâce aux interfaces de programmation d’Internet Archive. Le principe est celui des APIs et web services, qui épargnent des heures de copier-coller quand les pages à surveiller se comptent par dizaines.
Pour retrouver une page ou vérifier un domaine, la Wayback Machine répond en quelques clics, à condition de connaître l’adresse exacte et de garder en tête que ses trous ne prouvent rien. Pour un site français ancien, les archives de la BnF gardent souvent ce que l’archive américaine a manqué.
Reste le cas où l’enjeu devient juridique. Une capture date une page de façon assez crédible pour que l’Office européen des brevets s’en serve, mais devant un juge français, c’est le constat d’un commissaire de justice qui pèse le plus lourd.
FAQ - Questions fréquentes
La Wayback Machine est-elle légale ?
Consulter ses archives est libre et gratuit, et Internet Archive étudie les demandes des propriétaires qui veulent retirer leurs pages. La BnF a fait un autre choix pour ses archives du web, qu’elle ne met pas en ligne par respect de la propriété intellectuelle.
Peut-on encore utiliser la Wayback Machine ?
Oui, le service est en ligne et gratuit sur web.archive.org. Certaines captures récentes se font toutefois plus rares, en particulier celles des grands médias qui limitent l’accès de ses robots.
Comment faire retirer son site de la Wayback Machine ?
Il faut écrire à info@archive.org en indiquant les adresses concernées, la période à exclure et celle pendant laquelle vous contrôliez le site. Chaque demande est examinée au cas par cas, sans garantie de résultat.
Peut-on récupérer un site entier sur la Wayback Machine ?
Non, pas en un clic, car l’archive ne fournit pas d’export d’un site complet et Save Page Now n’enregistre qu’une page à la fois. On consulte donc les pages une par une en suivant les liens d’une capture, ou l’on passe par les interfaces de programmation d’Internet Archive pour un traitement en masse.

L'auteur
Romain Frutos
Consultant SEO · Fondateur d'Extenzilla
Il accompagne depuis 6 ans entreprises et agences sur leur visibilité : SEO technique, stratégie sémantique, netlinking, et désormais visibilité dans les moteurs IA.